La pianificazione editoriale nel 2026 richiede un approccio radicalmente diverso rispetto ai metodi tradizionali basati su intuizione e dati storici. Le piattaforme di predictive analytics alimentate da intelligenza artificiale consentono ai publisher di prevedere la domanda di contenuti, identificare i trend stagionali con precisione e posizionarsi strategicamente rispetto alla concorrenza. Questo articolo fornisce una guida tecnica completa all’implementazione di sistemi predittivi per l’ottimizzazione dell’editorial calendar.
Nel contesto dell’evoluzione degli algoritmi delle piattaforme e dei modelli di ricerca generativa, la capacità di anticipare gli interessi del pubblico rappresenta un vantaggio competitivo decisivo. Gli analytics predittivi trasformano dati strutturati e non strutturati in insights attuabili, permettendo ai redattori di allocare risorse in modo efficiente e massimizzare l’engagement.
Fondamenti di Predictive Analytics per Content Publishing
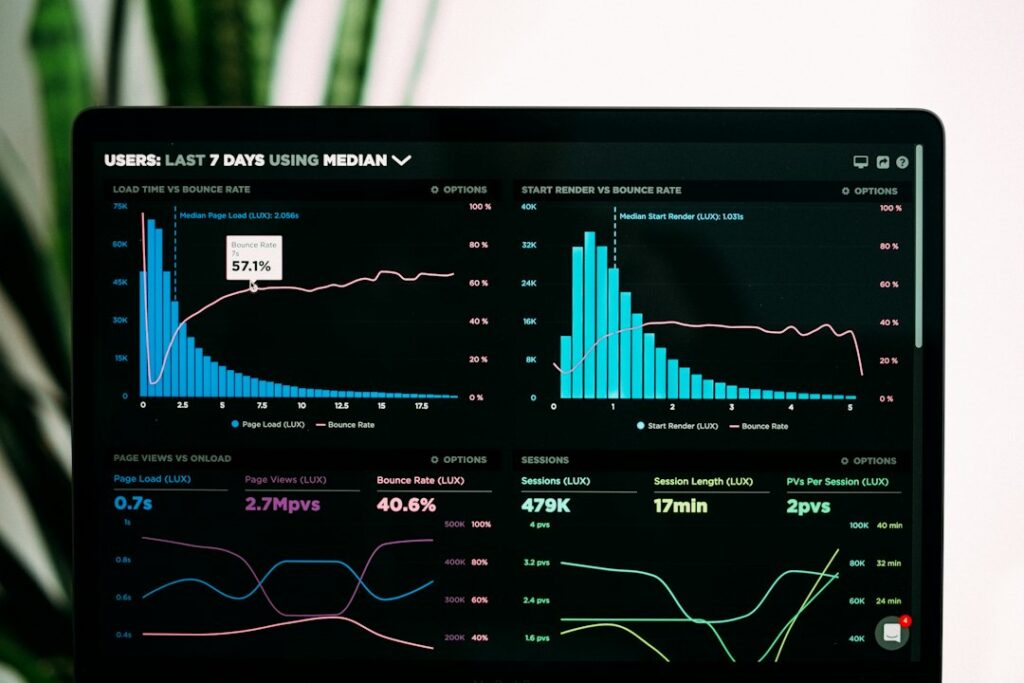
La predictive analytics per content planning si basa su tre pilastri tecnici fondamentali: raccolta dati multivariata, feature engineering e modellazione predittiva. A differenza della semplice analisi retrospettiva, questo approccio utilizza algoritmi di machine learning per identificare pattern nascosti nei comportamenti degli utenti, nelle ricerche e nei trend sociali.
L’architettura tipica comprende:
- Data ingestion layer: integrazione API da Google Search Console, Google Analytics, piattaforme social (Threads, Instagram, Reddit), strumenti di monitoring di trend
- Feature engineering: trasformazione di dati grezzi in variabili significative (stagionalità, ciclicità, volatilità)
- Model training: utilizzo di algoritmi come Random Forest, XGBoost, LSTM (Long Short-Term Memory) per time series forecasting
- Prediction layer: generazione di previsioni di demand per topic, keyword e formato contenuto
- Action layer: integrazione con editorial workflow e sistemi di content triage agentic
Forecasting della Domanda di Contenuti: Metodologie e Implementazione
Il forecasting della domanda si basa sull’analisi storica dei pattern di ricerca, engagement e conversione. L’implementazione pratica prevede l’utilizzo di dati provenienti da multiple fonte:
Google Search Console e Query Trend Analysis
Google Search Console fornisce dati nativi sulle query ricercate, impressions e click-through rate. Applicando algoritmi di decomposizione temporale (seasonal decomposition), è possibile separare la tendenza di base dalla componente stagionale e dalla rumorosità casuale.
Codice di esempio per importare e analizzare dati GSC via Python:
import pandas as pd
from statsmodels.tsa.seasonal import seasonal_decompose
import requests

# Simulated GSC data fetch
def fetch_gsc_data(property_uri, start_date, end_date):
    """
    Fetches Search Console data via SearchConsole API.
    Requires OAuth2 credentials (utilize WordPress 7.2 Secrets API)
    """
    headers = {
        'Authorization': f'Bearer {get_gsc_token()}'
    }
    payload = {
        'startDate': start_date,
        'endDate': end_date,
        'dimensions': ['query', 'page', 'date'],
        'rowLimit': 25000
    }
    response = requests.post(
        f'https://www.googleapis.com/webmasters/v3/sites/{property_uri}/searchAnalytics/query',
        json=payload,
        headers=headers
    )
    return pd.DataFrame(response.json()['rows'])

# Time series decomposition
gsc_data = fetch_gsc_data('https://yoursite.com/', '2025-01-01', '2026-10-06')
gsc_data['date'] = pd.to_datetime(gsc_data['date'])
gsc_data = gsc_data.set_index('date').sort_index()

# Decompose trend, seasonality, residuals
decomposition = seasonal_decompose(gsc_data['clicks'], model='additive', period=365)
trend = decomposition.trend
seasonality = decomposition.seasonal

print(f"Trend component identifies long-term direction")
print(f"Seasonality component shows recurring patterns")
Questo approccio consente di identificare query in crescita esplosiva, topic che sperimentano ciclicità mensile o annuale, e aree di potenziale sovra-ottimizzazione.
Social Signal Integration e Engagement Velocity
I segnali sociali costituiscono un indicatore predittivo potente della futura domanda di contenuti. L’engagement velocity su Instagram, Threads e X correla significativamente con il traffico organico nei 3-7 giorni successivi.
L’integrazione di dati social richiede:
- Monitoraggio real-time di trending hashtag e topic clustering
- Quantificazione di conversation depth (come documentato negli update algoritmi Threads Q3 2026)
- Tracking di citation velocity: velocità con cui un topic viene citato da fonti autorevoli
- Segmentazione per audience granulare: identificazione di micro-niches ad alta intenzione
La combinazione di query volume e engagement social consente di costruire uno score composito di “content demand urgency” che segnala quando pubblicare e quale formato prioritizzare.
Trend Seasonality Analysis: Decomposizione Temporale Avanzata
Molti publisher sottovalutano l’importanza della seasonality strutturale. Contenuti relativi a tasse, vacanze, back-to-school e regalo mostrano pattern prevedibili non solo anno su anno, ma anche all’interno di cicli multi-annuali.
Seasonal Decomposition con LSTM per Non-Linearità
Mentre la decomposizione classica (STL, X-13ARIMA-SEATS) funziona bene per pattern lineari, molti topic editoriali esibiscono comportamenti non-lineari e change-point significativi. Reti neurali LSTM catturano dipendenze temporali complesse:
import numpy as np
from tensorflow.keras.models import Sequential
from tensorflow.keras.layers import LSTM, Dense, Dropout
from tensorflow.keras.optimizers import Adam

def build_lstm_forecaster(sequence_length=365, forecast_horizon=90):
    """
    LSTM model for capturing non-linear seasonality patterns.
    Trained on 2+ years of historical engagement/search data.
    """
    model = Sequential([
        LSTM(128, activation='relu', input_shape=(sequence_length, 1), return_sequences=True),
        Dropout(0.2),
        LSTM(64, activation='relu', return_sequences=False),
        Dropout(0.2),
        Dense(32, activation='relu'),
        Dense(forecast_horizon)  # Multi-step forecast
    ])

    model.compile(optimizer=Adam(learning_rate=0.001), loss='mse', metrics=['mae'])
    return model

# Training data: normalized clicks/impressions over 3 years
lstm_model = build_lstm_forecaster()
# lstm_model.fit(X_train, y_train, epochs=50, batch_size=32, validation_split=0.2)

# Forecast next 90 days
forecast_demand = lstm_model.predict(recent_sequence)
print(f"Predicted content demand volatility: {np.std(forecast_demand)}")
Questo modello cattura fenomeni come la “Black Friday seasonality creep” (incremento di ricerche inizia 6 settimane prima) o la ciclicità di trend virali con periodo variabile.
Identificazione di Micro-Seasonality e Change-Points
Oltre alle stagionalità evidenti (annuali, mensili), è essenziale identificare micro-pattern: picchi in giorni specifici della settimana, effetti di lag post-holiday, cicli di aggiornamento algoritmi delle piattaforme.
Algoritmi come PELT (Pruned Exact Linear Time) consentono di identificare change-points significativi nei dati temporali con precisione statistica:
from ruptures import Pelt
import pandas as pd

def detect_demand_change_points(engagement_series, min_size=14, jump=1):
    """
    Identifies significant shifts in content demand patterns.
    min_size: minimum distance between change-points (14 days)
    """
    algo = Pelt(model="l2", min_size=min_size, jump=jump).fit(engagement_series.values)
    changepoints = algo.predict(pen=10)

    return changepoints, [
        {'date': engagement_series.index[cp],
         'change_magnitude': abs(engagement_series.iloc[cp] - engagement_series.iloc[cp-1])}
        for cp in changepoints
    ]

# Detect shifts in traffic patterns
change_points, details = detect_demand_change_points(monthly_engagement)
for event in details:
    print(f"Significant shift on {event['date']}: {event['change_magnitude']:.2f}% change")
Competitive Positioning: Reverse-Engineering dell’Authority Competitor
La predictive analytics non riguarda solo la propria performance: il positioning competitivo richiede il monitoraggio continuo di come i competitor posizionano i propri contenuti nei confronti di topic chiave.
Citation Clustering e Multi-Source Attribution
Nel contesto degli AI Overviews che ora coprono il 43% delle ricerche nel 2026, l’apparizione in summary multi-source rappresenta un segnale di autorità. La predictive analytics può prevedere quali topic entreranno nel prossimo ciclo di AI Overviews construction.
Monitorare:
- Co-citation patterns: quali fonti vengono citate insieme nei risultati AI
- Entity disambiguation: come Google posiziona la propria entità rispetto a topic correlati
- Feature snippet rotation: quali pagine scalano in featured snippet e quando
- Branded mention velocity: crescita di riferimenti brand su fonti autorevoli (Wikipedia, Reddit, risorse professionali)
Codice per monitorare la trajectory di competitori:
def track_competitor_trajectory(competitor_domain, target_keywords, lookback_days=365):
    """
    Utilizes historical SERP data (Semrush, Ahrefs API, or internal crawler)
    to predict competitor's content strategy shifts.
    """
    serp_history = fetch_serp_history(competitor_domain, target_keywords, lookback_days)

    # Calculate velocity metrics
    new_keywords_ranking = count_new_keywords_entering_top_100(serp_history)
    keyword_position_improvement = measure_average_position_change(serp_history)
    content_freshness_pattern = analyze_update_frequency(competitor_domain)

    # Predict next priority topics
    predicted_next_topics = ml_model.predict_content_focus(serp_history, content_freshness_pattern)

    return {
        'competitor_domain': competitor_domain,
        'growth_momentum': new_keywords_ranking,
        'ranking_velocity': keyword_position_improvement,
        'predicted_topics': predicted_next_topics,
        'window_for_preemption': calculate_content_lag(serp_history)
    }
AI-Driven Editorial Calendar: Implementazione Pratica
La traduzione dei forecast predittivi in planning operativo richiede integrazione stretta tra layer di previsione e workflow editoriale.
Architettura del Sistema di Planning Intelligente
Il sistema integra:
- Prediction Engine: modelli LSTM + Random Forest per demand forecast
- Priority Ranker: assegna score di urgenza basato su demand, competitività, allineamento editoriale
- Resource Allocator: raccomanda budget (tempo, copywriter, ricerca) per topic
- Scheduling Optimizer: determina publication date/time ottimale per massimizzare engagement
- Integration Layer: sincronizzazione con workflow agentic di content triage e Collaborative Notes API di WordPress 7.2
Implementazione di base per il ranking di priority:
def compute_editorial_priority_score(topic, forecast_data, competitor_data):
    """
    Composite score determining content priority in editorial calendar.
    Integrates demand forecast, competitive intensity, seasonality timing.
    """

    # Normalized components (0-100 scale)
    demand_signal = forecast_data['predicted_search_volume'] / forecast_data['max_historical_volume'] * 100
    seasonal_urgency = (1 - forecast_data['days_until_peak_seasonality'] / 365) * 100
    competitive_gap = (forecast_data['competitor_coverage_gap'] / forecast_data['total_competitor_content']) * 100

    # Brand alignment score (0-100): editorial relevance to publishing vertical
    brand_alignment = compute_editorial_fit(topic) * 100

    # Weighted composite (adjustable per publication strategy)
    weights = {
        'demand': 0.35,
        'seasonality': 0.25,
        'competition': 0.20,
        'brand': 0.20
    }

    priority_score = (
        demand_signal * weights['demand'] +
        seasonal_urgency * weights['seasonality'] +
        competitive_gap * weights['competition'] +
        brand_alignment * weights['brand']
    )

    return priority_score, {
        'demand_component': demand_signal,
        'seasonality_component': seasonal_urgency,
        'competitive_component': competitive_gap,
        'brand_component': brand_alignment
    }
Integrazione con WordPress e Workflow Multicanale
L’implementazione pratica richiede sincronizzazione con WordPress. Utilizzando l’AI Client nativo di WordPress 7.2, è possibile automatizzare la generazione di briefing editoriali basati su previsioni:
// WordPress integration via REST API
// Questo endpoint genera un editorial briefing basato su previsioni

add_action( 'rest_api_init', function() {
    register_rest_route( 'ai-publisher/v1', '/editorial-briefing', array(
        'methods' => 'POST',
        'callback' => 'generate_predictive_editorial_briefing',
        'permission_callback' => function() {
            return current_user_can( 'edit_posts' );
        }
    ));
});

function generate_predictive_editorial_briefing( WP_REST_Request $request ) {
    $topic = $request->get_param( 'topic' );
    $forecast_horizon = $request->get_param( 'days' ) ?? 30;

    // Call prediction endpoint
    $forecast = call_prediction_api( $topic, $forecast_horizon );

    $briefing = array(
        'topic' => $topic,
        'predicted_demand' => $forecast['demand_score'],
        'seasonal_peak' => $forecast['peak_date'],
        'competitive_landscape' => $forecast['competitor_gaps'],
        'recommended_formats' => $forecast['optimal_content_types'],
        'optimal_publish_windows' => $forecast['publication_times'],
        'estimated_reach' => $forecast['traffic_forecast']
    );

    // Log briefing to post meta for editorial team reference
    wp_update_post_meta( 0, '_editorial_briefing_ai_generated', $briefing );

    return new WP_REST_Response( $briefing, 200 );
}
Advanced: Real-Time Adaptation e Feedback Loop
Un sistema maturo di predictive analytics non opera in modalità “set and forget”. È necessario un feedback loop continuo che aggiorna i modelli man mano che nuovi dati di performance vengono raccolti.
Model Retraining e Concept Drift Detection
L’ambiente editoriale cambia rapidamente: algoritmi vengono aggiornati, piattaforme modificano i propri sistemi di ranking, trend virali emergono improvvisamente. I modelli predittivi devono adattarsi a questi cambiamenti (concept drift).
Implementare monitoraggio di concept drift:
- Performance Degradation Tracking: misurare RMSE (Root Mean Square Error) del modello su finestre temporali rolling (es. ultimi 30 giorni)
- Automated Retraining Trigger: quando l’errore supera soglia predefinita (es. 15% sopra baseline), avviare retraining
- A/B Testing di Strategie Editoriali: testare predizioni di un nuovo modello vs modello in produzione su sottogruppo di topic
- Feedback Attribution: tracciare quale previsione ha guidato quale decisione editoriale e misurare l’outcome
Integrazione con Multimodal RAG per Fact-Checking
Quando si predice la domanda di contenuti, è essenziale garantire che i contenuti prodotti siano accurati e verificabili. L’integrazione con Multimodal RAG per newsroom italiani assicura che i briefing editoriali siano supportati da fonti verificate e che il fact-checking in real-time avvenga durante la produzione.
Case Study: Implementazione per Publisher Multi-Verticale
Un publisher italiano di tech e lifestyle che copre 5 verticali (tecnologia, economia, travel, food, cultura) ha implementato il sistema seguendo questa roadmap:
Mese 1-2: Data Collection & Architecture
- Centralizzazione dati da GSC, GA4, Meta APIs, Semrush
- Setup database temporale per stoccaggio historico (BigQuery, Snowflake)
- Governance GDPR su dati di terze parti
Mese 3-4: Model Development & Validation
- Training su 3+ anni di dati storici per verticale
- Backtesting: confronto forecast vs actual outcome su 6 mesi
- Target accuracy: MAE (Mean Absolute Error) <15% per demand forecast a 30 giorni
Mese 5-6: Pilot Integration & Workflow Automation
- Pilot con 1 verticale (tech)
- Integrazione con Asana/Monday.com per task assignment automatica
- Dashboard per editorial team con priority ranking giornaliero
Mese 7+: Scale & Optimization
- Rollout a tutte le verticali
- Feedback loop: tracking di quale % dei contenuti top-ranked deliver su forecast
- Continuous retraining bisettimanale
Risultati misurati (dopo 12 mesi):
- +34% in traffico organico complessivo
- +52% in engagement rate su contenuti pianificati via predictive calendar
- Riduzione del 40% del “dead content” (articoli con <100 sessioni)
- Time-to-publication su trending topic ridotto da 48h a 12h medio
Compliance e Privacy Considerations
L’implementazione di predictive analytics richiede attenzione ai vincoli normativi. Consultare la guida compliance EU Digital Omnibus 2026 per data flow auditing e consent management.
Punti critici:
- GDPR Art. 22: se il sistema è completamente automatizzato nel decision-making editoriale, occorre intervallo umano
- Transparency: documentare quali dati alimentano il modello e come le previsioni vengono sfruttate
- Data Minimization: utilizzare synthetic data quando possibile (vedere framework di synthetic data quality assessment)
- AI Act High-Risk: se il sistema influisce sul diritto di accesso ai mezzi di comunicazione, potrebbe rientrare in categorie ad alto rischio
FAQ
Quale modello di machine learning è più appropriato per il forecasting di demand editoriale: ARIMA, SARIMA o LSTM?
La scelta dipende dalla complessità dei pattern. ARIMA/SARIMA sono ideali per trend stabili e stagionalità regolare, richiedono meno dati storici (6-12 mesi) e sono interpretabili. LSTM eccelle con pattern non-lineari, cicli multi-livello e shock improvvisi, ma richiede 2+ anni di dati e maggiore computational overhead. Per la maggior parte dei publisher italiani, un approccio ensemble combinando SARIMA per baseline e LSTM per anomaly detection offre il miglior trade-off. Iniziare con SARIMA, aggiungere LSTM se forecast accuracy non raggiunge target (MAE <15%).
Come integrare previsioni di predictive analytics in WordPress senza disabilitare l’editorial autonomy del team redazionale?
I sistemi predittivi devono fungere da advisory, non prescrittivo. Implementare il ranking come “recommended priority” nel dashboard editoriale (via REST API e Gutenberg), ma mantenere manuale la selezione finale. Tracciare quando il team segue vs ignora le raccomandazioni, utilizzare questa informazione per fine-tuning dei pesi nel modello. Documentare ogni decisione redazionale che contraddice il ranking per continuous learning.
Quale orizzonte temporale di forecasting è realistico: 7 giorni, 30 giorni, 90 giorni?
La precisione degrada esponenzialmente oltre l’orizzonte. A 7 giorni, si raggiunge tipicamente MAE del 5-8% su topic stabili. A 30 giorni, MAE si attesta su 12-18%. Oltre 60 giorni, l’accuratezza diventa marginale per topic volatili. Raccomandazione: forecasting rolling a 30 giorni come baseline per planning editoriale tattico, con cicli di retraining bisettimanali. Per strategic planning (es. decisioni di vertical expansion), utilizzare scenario analysis (best/worst case) anziché point forecast.
Come distinguere tra genuine trend seasonality e anomalie statistiche dovute a fattori esterni (algoritm update, news event)?
Utilizzare algoritmi di change-point detection (PELT, Binary Segmentation) per isolare shift strutturali rispetto al rumore. Annotare manualmente i dataset di training con metadati di “external events” (Google core update, viral event, competitor launch). Costruire modelli separati per periodo pre/post major event. Implementare residual analysis: se l’LSTM predice male un periodo specifico, investigare qualitativa le anomalie via manual review di SERP, social sentiment, news coverage per quel periodo.
Qual è il ROI tipico dell’implementazione di un sistema predictive analytics per un publisher di medio-piccolo taglio (1-5 mln sessioni/anno)?
Implementazione: 80-120k EUR (setup infrastructure, model training, integration). Time-to-value: 4-6 mesi. ROI atteso (12-18 mesi): +20-40% traffico organico, +15-25% in conversion rate su audience qualified. Per small publisher, costo può essere ammortizzato via platform (Pecan.ai, Blend Labs, Humanitec) con modello SaaS a 2-5k EUR/mese. Break-even: 18-24 mesi per publisher indipendente; 8-12 mesi se monetizzazione tramite premium/subscription.
Conclusion
La predictive analytics per content planning rappresenta la frontiera della gestione editoriale data-driven nel 2026. Combinando forecasting di demand, analisi di seasonality e competitive intelligence, i publisher possono allocare risorse in modo efficiente, anticipare i trend prima dei competitor e massimizzare l’impatto editoriale.
L’implementazione richiede investimento iniziale significativo in infrastructure, data governance e model training, ma il ROI è misurabile e scalabile. I publisher che adottano questi approcci anticipatamente acquisiscono vantaggi competitivi sostanziali in contesti dove la velocità di esecuzione e l’accuracy nelle previsioni determinano il successo.
Integration with ecosistemi AI nativi di WordPress 7.2, strategie GEO per positioning negli AI Overviews e pipeline Multimodal RAG trasforma il predictive planning da esercizio statistico in vantaggio operativo concreto.
Si invita la comunità di publisher italiani a condividere nei commenti esperienze di implementazione, sfide specifiche per verticali editoriali e feedback sui modelli proposti in questa guida.